Googlebot bloccato da Cloudflare e firewall: cause, rischi SEO e soluzioni
Articolo di Team Digital Marketing
Un'analisi dei blocchi accidentali di Googlebot causati da Cloudflare e dai firewall, con istruzioni per riconoscere gli errori di scansione, correggere le impostazioni e gestire l'accesso dei crawler AI

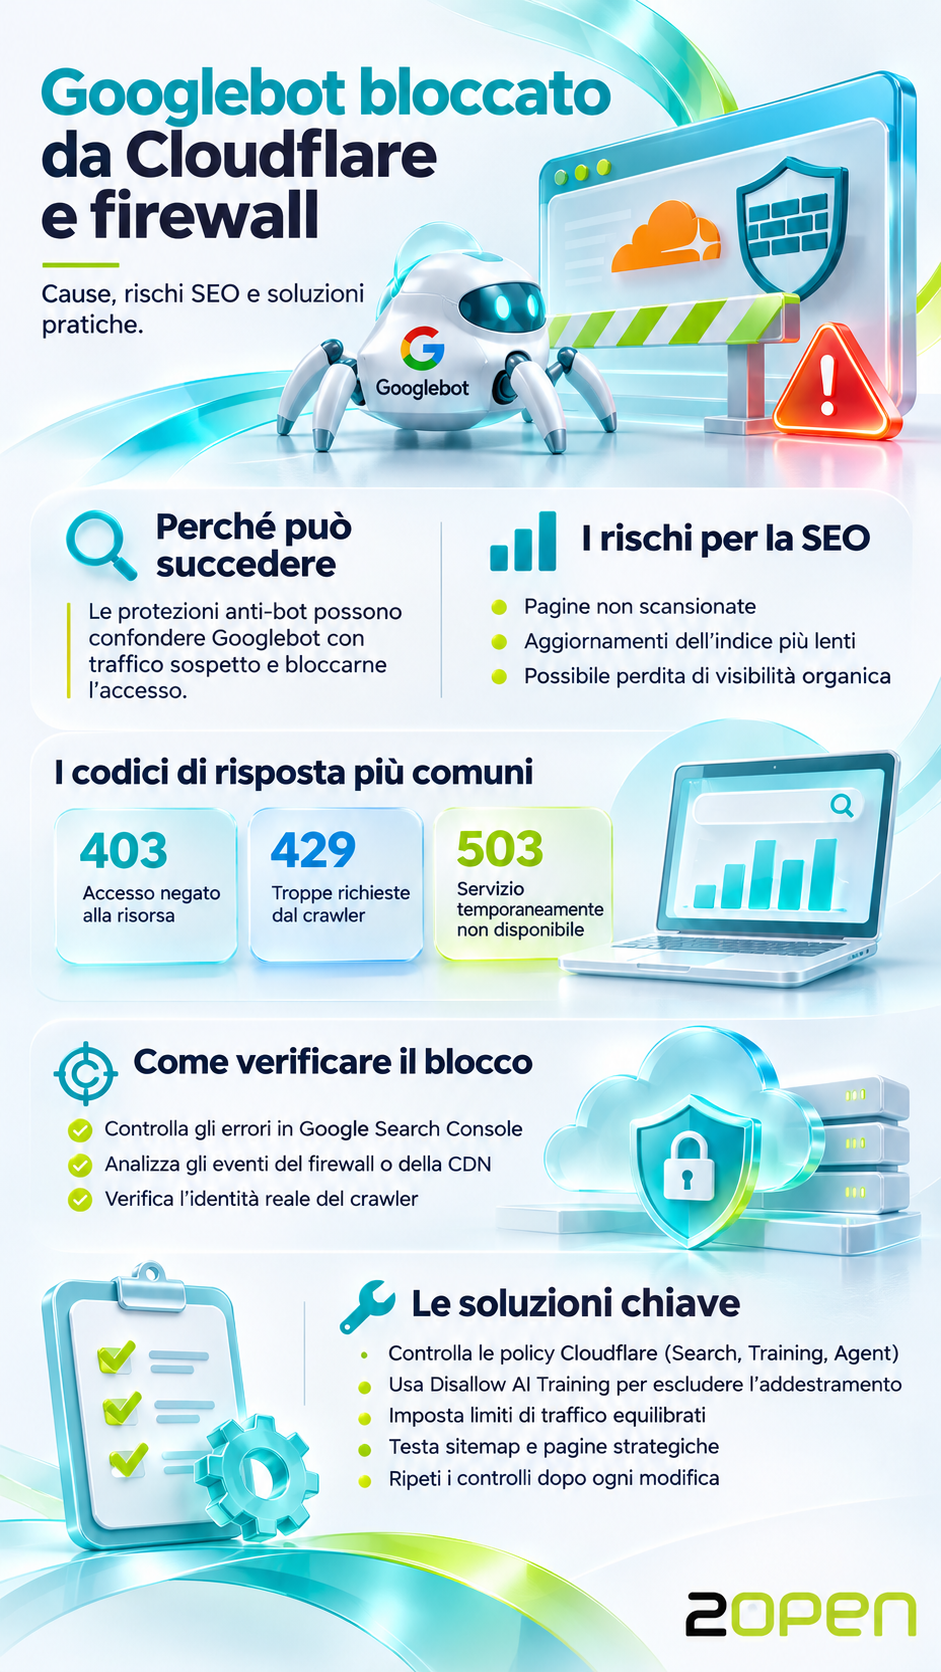
Le protezioni contro bot e agenti AI possono bloccare anche Googlebot, Bingbot e altri crawler dei motori di ricerca. Il problema emerge quando Cloudflare, un firewall applicativo o un servizio anti-bot classifica come sospette richieste automatiche legittime. Un blocco di Googlebot può ostacolare la scansione delle pagine, ritardare gli aggiornamenti dell'indice e, se persiste, compromettere la visibilità organica.
Nel 2026 alcune segnalazioni evidenziano risposte HTTP 403 in presenza di specifiche policy Cloudflare. A settembre il provider introduce nuovi controlli per separare la ricerca dall'addestramento AI. Google, a sua volta, pubblica indicazioni sulle migrazioni verso le CDN e il 17 novembre presenta una guida dedicata all'accesso di Google-Agent.
Per capire se il sito presenta davvero il problema servono riscontri tecnici verificabili: errori di scansione, eventi del firewall, identità dei crawler e risposte HTTP. Questa guida chiarisce dove cercarle, come interpretarle e quali impostazioni esaminare prima di intervenire.
In questo approfondimento
- Perché Cloudflare e i firewall possono bloccare Googlebot
- Cloudflare e i nuovi controlli sui crawler AI nel 2026
- Googlebot, Bingbot e Google-Agent: quali differenze
- Cosa succede alla SEO quando Googlebot riceve errori
- Come riconoscere un blocco con Search Console e i log
- Come controllare le impostazioni Cloudflare
- Rate limiting e blocchi su hosting e altre CDN
- Google-Agent: le istruzioni ufficiali di Google
- Come limitare i bot AI senza ostacolare la scansione
- Domande frequenti
- Sintesi finale e controlli periodici
- Fonti e approfondimenti
Perché Cloudflare e i firewall possono bloccare Googlebot
Una richiesta proveniente da Googlebot attraversa la stessa infrastruttura che protegge il sito dalle altre connessioni. Se il sistema confonde un crawler attendibile con un programma aggressivo, l'accesso può interrompersi prima ancora che il server riceva la richiesta.
Quando la protezione scambia la scansione per traffico sospetto
Una CDN e un WAF possono analizzare indirizzi IP, reputazione, frequenza degli accessi e caratteristiche delle richieste. In base alle policy, consentono il traffico, impongono una verifica oppure restituiscono un errore. I falsi positivi compaiono quando le regole colpiscono richieste legittime.
Un sito ospitato su un servizio di hosting web con protezioni anti-bot può quindi funzionare per i visitatori e risultare inaccessibile a Googlebot. Il controllo dal browser dell'amministratore non basta: il firewall può applicare condizioni diverse in base all'IP o all'identità dichiarata dal client.
Perché CAPTCHA e limiti alle richieste possono interferire con la SEO
Googlebot visita automaticamente molti URL e può modificare il ritmo delle richieste quando rileva variazioni nelle prestazioni del sito. Una regola che limita in modo indiscriminato tutte le connessioni automatizzate può rispondere con 429, 403 o con una pagina di verifica JavaScript. Se il crawler riceve un CAPTCHA anziché il contenuto, la pagina visibile cambia rispetto a quella che vede una persona.
Il rischio aumenta quando la protezione interessa soltanto alcune sezioni: la homepage restituisce 200, mentre archivi, immagini, sitemap o nuove schede prodotto incontrano un blocco. Per questo un controllo rappresentativo deve coprire più tipologie di URL.
Cloudflare e i nuovi controlli sui crawler AI nel 2026
Il caso Cloudflare mostra perché una regola contro l'addestramento AI può avere effetti inattesi sulla ricerca. Il problema riguarda soprattutto i crawler che utilizzano una stessa identità per più scopi.
Le segnalazioni dell'estate e la svolta del 15 settembre
Nell'estate 2026 emergono casi di richieste Googlebot e Bingbot con risposta 403 in presenza di particolari configurazioni Cloudflare. Queste segnalazioni documentano il rischio tecnico, senza dimostrare un guasto generalizzato della piattaforma. Il 15 settembre Cloudflare introduce Disallow AI Training, una modalità per esprimere il rifiuto dell'addestramento AI e mantenere la scansione destinata alla ricerca.
Il nodo riguarda i mixed-use crawler, tra cui Googlebot, Bingbot e Applebot. Cloudflare attribuisce ai bot categorie Search, Training e Agent; quando un crawler rientra in più categorie, una policy restrittiva può influire anche sulla sua attività di ricerca.
Block e Disallow AI Training: la differenza che conta
| Impostazione | Effetto |
|---|---|
| Search: Allow | Consente il traffico di ricerca nell'ambito della policy; altre regole WAF possono ancora intervenire. |
| Training: Block | Blocca i crawler della categoria, compresi quelli multiuso, con potenziale impatto sulla ricerca. |
| Training: Disallow AI Training | Pubblica preferenze di esclusione e preserva l'accesso dei crawler multiuso riconosciuti per Search. |
| Agent: Block | Blocca gli agenti della categoria interessata, in base alle impostazioni attive. |
Con Bot Preference Sync attivo, Cloudflare pubblica nel robots.txt le preferenze pertinenti e blocca al livello CDN i crawler dedicati all'addestramento previsti dalla policy. I crawler multiuso riconosciuti come affidabili mantengono l'accesso per Search. La modalità Block applicata a Training può invece interrompere anche questa attività.
Per Bingbot esiste una differenza pratica: Microsoft supporta preferenze sugli utilizzi AI attraverso controlli come NOARCHIVE, mentre il supporto a una preferenza di esclusione dall'addestramento via robots.txt risulta previsto per il 2027. Oggi Disallow AI Training non trasmette automaticamente a Bing quel rifiuto attraverso robots.txt.
Cloudflare prevede anche la migrazione delle vecchie opzioni Block AI Bots verso le policy più granulari. Contano le regole attuali, non il nome dell'interruttore che un amministratore ricorda di aver attivato mesi prima. La verifica interessa anche chi si affida a una consulenza sistemistica per la gestione di firewall e server.
Googlebot, Bingbot e Google-Agent: quali differenze
Identità e finalità di un crawler non coincidono sempre. Prima di predisporre eccezioni conviene capire quali sistemi servono alla scansione dei motori di ricerca e quali operano su richiesta degli utenti oppure per usi AI specifici.
| Identità | Funzione | Indicazione |
|---|---|---|
| Googlebot | Scansione per Google Search | Consentire sulle risorse pubbliche che il sito vuole rendere indicizzabili. |
| Bingbot | Scansione per Bing | Consentire sulle risorse destinate a Bing. |
| Googlebot-Image | Scansione delle immagini | Controllare l'accesso alle immagini pertinenti. |
| Google-InspectionTool | Test degli URL negli strumenti Google | Consentire le richieste necessarie ai test. |
| Google-Agent | Navigazione e operazioni su richiesta degli utenti | Valutare l'accesso ai percorsi agentici desiderati. |
| Google-Extended | Token di controllo per specifici utilizzi AI | Gestire le preferenze tramite robots.txt. |
| GPTBot e altri crawler AI | Attività dichiarate dai rispettivi operatori | Distinguere finalità e identità prima di decidere. |
Google-Extended non equivale a Googlebot
Google-Extended è un token per robots.txt, non uno User-Agent HTTP autonomo. Permette di controllare determinati usi dei contenuti per l'addestramento dei modelli Gemini e il grounding nei prodotti e servizi ai quali si applica. La normale Ricerca Google continua a utilizzare Googlebot: la direttiva per Google-Extended non comporta di per sé l'esclusione dalla ricerca tradizionale.
La distinzione riguarda anche progetti di realizzazione di e-commerce con cataloghi e schede prodotto. L'accessibilità per Google Search e le preferenze sull'utilizzo AI richiedono scelte separate, soprattutto quando il catalogo cambia spesso.
Cosa succede alla SEO quando Googlebot riceve errori
Un blocco influenza anzitutto la scansione. L'effetto sull'indicizzazione dipende dal codice di risposta, dalla durata dell'errore e dal fatto che Google conosca già la pagina.
Un errore 403 non equivale a un 429 o a un 503
| Codice | Significato | Possibile effetto |
|---|---|---|
| 403 Forbidden | Accesso negato | Google non acquisisce il contenuto; un URL già indicizzato può uscire dall'indice. |
| 429 Too Many Requests | Richieste eccessive | Google interpreta un possibile sovraccarico e riduce temporaneamente la scansione. |
| 503 Service Unavailable | Servizio temporaneamente indisponibile | Google rallenta le richieste; errori persistenti possono compromettere l'indice. |
| 200 con CAPTCHA | Risposta HTTP riuscita ma contenuto inatteso | Google può elaborare la pagina di verifica al posto del contenuto previsto. |
Google tratta i codici 4xx, con l'eccezione del 429, come segnali di contenuto non disponibile. I codici 429 e 5xx possono invece ridurre temporaneamente il ritmo delle richieste. Il 403 non limita correttamente la frequenza di scansione: usarlo contro un sovraccarico rischia conseguenze diverse da quelle desiderate.
Sitemap e singole pagine vanno controllate separatamente
Se Google non riesce a scaricare la sitemap XML, perde una fonte utile per scoprire gli URL, ma può continuare a trovare pagine tramite collegamenti e altre risorse. L'errore della sitemap non implica blocchi generalizzati sulle pagine elencate. Occorre verificare URL individuali, immagini e risorse necessarie al rendering.
Questo controllo assume particolare rilievo nelle migrazioni e nella realizzazione di siti web con verifiche tecniche di indicizzazione. Un portale può rispondere correttamente sulla homepage e negare l'accesso soltanto ad articoli recenti o pagine di dettaglio. Anche un calo del traffico organico, da solo, non dimostra l'esistenza di un blocco del crawler.
Come riconoscere un blocco con Search Console e i log
Una diagnosi attendibile collega tre informazioni: quale URL presenta il problema, che cosa restituisce il sistema di sicurezza e se la richiesta proviene davvero dal crawler dichiarato. Gli strumenti offrono indizi diversi, che vanno letti insieme.
Le anomalie da cercare in Google Search Console
Il rapporto Indicizzazione delle pagine permette di esaminare gli URL per cui Google incontra difficoltà. Nelle Statistiche di scansione conviene osservare la distribuzione delle risposte HTTP, il numero delle richieste e lo stato dell'host. Un aumento dei 4xx, dei 429 o dei 5xx richiede verifiche differenti. Un calo della scansione resta un indizio, perché può dipendere anche da una minore necessità di aggiornare le pagine.
Con Controllo URL, il test live verifica l'accessibilità in quel momento. Le richieste dello strumento possono utilizzare Google-InspectionTool, distinto dall'identità usata nelle scansioni ordinarie. Un test live riuscito non dimostra quindi che ogni richiesta Googlebot attraversi le stesse regole del firewall.
Quali campi incrociare negli eventi WAF
Per individuare la causa bisogna confrontare data e ora, percorso richiesto, indirizzo IP, User-Agent, azione della protezione e identificativo della regola. Gli eventi della CDN mostrano che cosa fa il firewall; i log HTTP, quando disponibili, mostrano il codice che il sistema restituisce. Una richiesta che la CDN interrompe non raggiunge il server e quindi non compare nei log dell'hosting.
Come verificare l'identità autentica di Googlebot
Qualsiasi programma può inserire Googlebot nell'header User-Agent. Per una verifica affidabile, Google pubblica i range dei crawler comuni nel file common-crawlers.json. In alternativa, il controllo reverse DNS deve restituire un nome host Google valido; una successiva risoluzione diretta deve riportare all'IP iniziale. L'identità va verificata prima di creare eccezioni WAF.
Un caso ipotetico: la sitemap funziona nel browser, Googlebot riceve 403
Si immagini un portale editoriale che aggiorna il firewall e, poche ore dopo, registra errori nel recupero della sitemap. La verifica del traffico nella CDN mostra il seguente evento simulato: non riproduce log originali del pannello Cloudflare.
EVENTO WAF - simulazione
Percorso: /sitemap.xml
Identita dichiarata: Googlebot
IP client: [verificato nei range Google]
Azione WAF: Block
Policy coinvolta: Training Block
Il sistema di registrazione delle risposte HTTP al perimetro CDN mostra, per la stessa richiesta, lo stato 403. L'amministratore identifica quindi il blocco, verifica l'autenticità dell'IP e controlla le policy applicabili. Dopo la correzione osserva una nuova richiesta autentica verso la medesima sitemap con risposta 200. Il ripristino resta circoscritto a quella risorsa: per confermare il risultato sul sito occorrono test su ulteriori URL e il monitoraggio delle scansioni successive.
I dati di Search Console documentano la scansione; l'analisi delle visite può aiutare a capire se il problema coincide con una variazione del traffico organico. Una consulenza Web Analytics per interpretare i dati GA4 è utile in questa seconda fase, senza confondere le visite degli utenti con le richieste automatiche dei crawler.
Come controllare le impostazioni Cloudflare
Quando le evidenze indicano una regola Cloudflare, la correzione deve intervenire sulla policy effettivamente responsabile. Autorizzare indiscriminatamente tutti i bot esporrebbe il sito a richieste che il firewall ha il compito di limitare.
Controllare Search, Training e Agent nel pannello
Il percorso di riferimento è Security → Settings → Bot traffic, nell'area delle policy di accesso per crawler e agenti AI. Lì è possibile verificare Search, Training e Agent, con differenze legate al piano e agli aggiornamenti dell'interfaccia.
Per chi desidera preservare l'accesso alla ricerca e comunicare una preferenza contraria all'addestramento AI, una configurazione da esaminare prevede Search: Allow e Training: Disallow AI Training, con Bot Preference Sync attivo. La scelta resta contestuale: occorre controllare gli altri blocchi e gli obiettivi del sito.
Perché Search: Allow può non risolvere il problema
Le regole WAF personalizzate, i blocchi geografici, le protezioni anti-bot e il rate limiting possono incidere sul traffico anche quando Search risulta consentito. Cloudflare distingue Bot Fight Mode, che non supporta normali eccezioni WAF Skip, da Super Bot Fight Mode, che prevede eccezioni specifiche. La priorità delle regole e l'eventuale presenza di challenge richiedono quindi una verifica separata.
Dopo la modifica, è utile osservare nuovi eventi di sicurezza e confrontarli con le risposte ricevute su sitemap, pagine di categoria, contenuti recenti e immagini. La semplice scomparsa del 403 da un singolo test non chiude automaticamente l'indagine.
Rate limiting e blocchi su hosting e altre CDN
Le stesse difficoltà possono emergere anche con provider diversi da Cloudflare. Il problema riguarda la relazione tra regole di sicurezza, capacità del server e identificazione del traffico attendibile.
Migrazioni CDN, geoblocking e limiti troppo rigidi
Durante una migrazione, una cache vuota può trasferire più richieste al server di origine. Google può modificare temporaneamente il ritmo di scansione in risposta alle prestazioni osservate. Il rate limiting troppo restrittivo può produrre 429; il geoblocking può negare l'accesso agli IP esteri utilizzati dai crawler. Il sovraccarico reale richiede interventi sulla capacità del servizio e, quando serve una misura temporanea, risposte HTTP appropriate come 429 o 503.
Quali domande rivolgere al provider
Con server dedicati e servizi di gestione dell'infrastruttura conviene verificare dove consultare gli eventi WAF, quali regole intervengono prima del server, come il sistema riconosce i crawler e con quale frequenza aggiorna gli indirizzi IP ufficiali. Le eccezioni selettive richiedono controlli periodici, soprattutto quando convivono più livelli di protezione.
Google-Agent: le istruzioni ufficiali di Google
La guida pubblicata da Google il 17 novembre 2026 riguarda gli agenti che navigano sul web ed effettuano azioni su richiesta degli utenti. La sua finalità è diversa dalla normale scansione di Googlebot per Search.
Identità, indirizzi IP e firme HTTP
Le richieste Google-Agent contengono un User-Agent con la stringa Google-Agent e provengono da indirizzi presenti in user-triggered-agents.json. Google sperimenta inoltre Web Bot Auth, un protocollo di autenticazione basato sulle firme HTTP previste dallo standard RFC 9421. Le richieste che partecipano all'esperimento possono includere i seguenti header, qui in forma puramente illustrativa:
Signature-Agent: g="https://agent.bot.goog"
Signature-Input: g=(...)
Signature: g=:...:
Le firme reali contengono valori e parametri che questo schema omette. La verifica utilizza la directory delle chiavi pubbliche https://agent.bot.goog/.well-known/http-message-signatures-directory e deve validare effettivamente la firma secondo il protocollo. La presenza degli header non basta ad autenticare una richiesta.
Quando un agente supera la homepage e incontra un blocco
Un agente può raggiungere correttamente la homepage e fallire quando utilizza una ricerca interna, apre una scheda, applica un filtro o invia una richiesta API. Google raccomanda di controllare la priorità delle regole, le verifiche JavaScript e CAPTCHA, i limiti per IP condivisi e gli endpoint coinvolti nel percorso.
Nei progetti di sviluppo di applicazioni web con API e funzionalità interattive, l'accesso degli agenti richiede controlli specifici su autenticazione, autorizzazioni e dati riservati. La guida Google-Agent non presenta questa apertura come requisito per il ranking tradizionale.
Come limitare i bot AI senza ostacolare la scansione
La scelta dipende dalle finalità che il proprietario del sito desidera consentire. I crawler destinati alla ricerca, quelli che raccolgono contenuti per l'addestramento e gli agenti che eseguono azioni per gli utenti possono richiedere regole differenti.
Robots.txt e blocchi del firewall svolgono funzioni diverse
Il file robots.txt comunica istruzioni ai crawler che scelgono di rispettarle. Un WAF può impedire tecnicamente la richiesta. Per esprimere il rifiuto di specifici utilizzi AI supportati da Google-Extended, per esempio, un sito può pubblicare:
User-agent: Google-Extended
Disallow: /
Questa preferenza non equivale a un blocco della normale scansione Googlebot. Se Cloudflare utilizza Bot Preference Sync, occorre esaminare il robots.txt che il dominio restituisce effettivamente: le direttive gestite possono convivere con quelle già presenti sul server. Una risposta 200 del file non dimostra, da sola, che le pagine siano accessibili al crawler.
La scelta riguarda anche la presenza nei servizi AI
Le preferenze possono incidere sulle modalità con cui alcuni servizi AI utilizzano i contenuti, secondo gli strumenti dichiarati dai rispettivi operatori. In un progetto di consulenza AEO dedicata ai contenuti nei sistemi di risposta occorre distinguere visibilità su Google Search, usi di addestramento e funzionalità agentiche.
Google ha inoltre annunciato nel 2026 il futuro supporto a un controllo condiviso per l'addestramento AI nell'ambito del lavoro IETF AIPREF, con adozione prevista nel 2027. Gli standard evolvono ancora: le policy attuali richiedono verifiche periodiche e una valutazione distinta per ogni operatore.
Domande frequenti su Googlebot e crawler bloccati
Alcuni dubbi emergono soprattutto quando il sito sembra funzionare normalmente, mentre Search Console segnala problemi. Queste risposte riassumono le verifiche più utili.
Cloudflare può bloccare Googlebot anche con Search su Allow?
Sì. Altre regole WAF, blocchi geografici o policy applicabili possono negare le richieste. L'indagine deve includere gli eventi di sicurezza e l'ordine di valutazione delle regole.
Un errore 403 provoca immediatamente la deindicizzazione?
Non necessariamente. La persistenza dell'errore conta: Google può conservare per un periodo un URL già noto, ma le risposte 403 indicano contenuto non disponibile e possono portare alla sua rimozione dall'indice.
Come capire se Google non riesce a leggere la sitemap?
Search Console segnala i problemi di recupero della sitemap. I log della CDN aiutano a distinguere un blocco WAF da errori del server o difficoltà di connessione. Le singole pagine richiedono comunque verifiche separate.
Quanto tempo serve per recuperare l'indicizzazione?
Non esiste una tempistica garantita. La successiva scansione dipende da diversi fattori e la correzione del blocco non assicura il ritorno immediato alle posizioni precedenti.
Google-Agent deve accedere al sito per comparire su Google?
No. Googlebot e Google-Agent svolgono funzioni differenti: il primo riguarda la scansione per Search, il secondo le azioni agentiche richieste dagli utenti. Le autorizzazioni vanno valutate separatamente.
Sintesi finale: quali controlli eseguire periodicamente
Il rischio di un Googlebot bloccato da Cloudflare riguarda il modo in cui le protezioni classificano le richieste automatiche. Una regola può modificare l'accessibilità del sito senza alterare ciò che vede un normale visitatore. Il controllo dei crawler dovrebbe perciò accompagnare le migrazioni, gli aggiornamenti dei firewall e le modifiche alle policy anti-bot.
Per verificare che le protezioni rispettino gli obiettivi del sito, conviene adottare una routine semplice:
- Controllare le policy Search, Training e Agent della CDN.
- Confrontare anomalie di Search Console, eventi WAF e risposte HTTP.
- Verificare l'identità dei crawler tramite i range IP o i metodi ufficiali disponibili.
- Testare sitemap, pagine strategiche, immagini e percorsi interattivi pertinenti.
- Ripetere le verifiche dopo ogni modifica rilevante all'infrastruttura.
Integrare questi controlli nel lavoro di web marketing e monitoraggio della visibilità organica permette di riconoscere problemi che le sole statistiche di traffico non spiegano. La prova decisiva resta sempre la risposta che un crawler autentico ottiene dalle risorse che il sito intende rendere accessibili.
Fonti e approfondimenti
Cloudflare, Have it both ways: stay discoverable in search while disallowing AI training — sulle policy introdotte nel settembre 2026 e sui crawler multiuso.
Google Crawling Infrastructure, How HTTP status codes affect Google's crawlers — sul trattamento dei codici 403, 429 e 503.
Google Crawling Infrastructure, Allow Google-Agent traffic — su identità, firme HTTP e gestione dei blocchi per Google-Agent.
