Google BigQuery: cos'è, come funziona, costi e utilizzo per SEO e digital marketing
Articolo di Team Digital Marketing
Scopri cos'è Google BigQuery, come collegarlo a GA4 e Search Console, conservare e analizzare i dati SEO e marketing, i costi reali e i limiti da conoscere

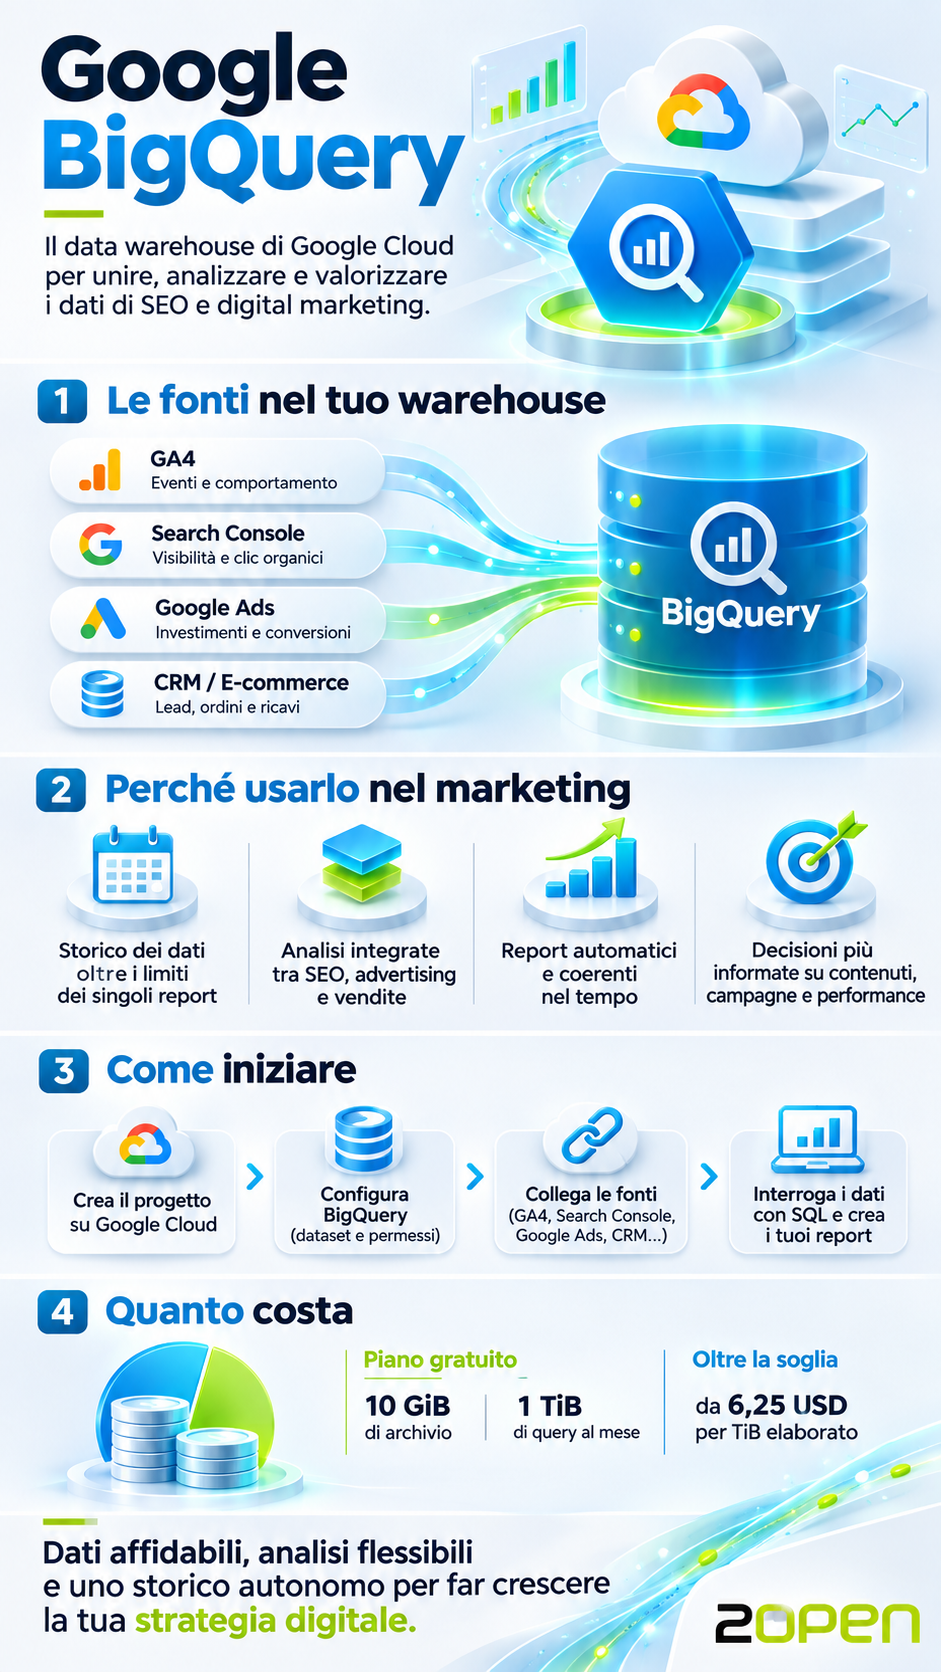
Google BigQuery è il data warehouse analitico di Google Cloud: conserva grandi volumi di informazioni e permette di interrogarli con SQL, senza amministrare direttamente i server che eseguono le elaborazioni. Nel digital marketing serve, fra le altre cose, a raccogliere dati di Google Analytics 4 (GA4), Search Console, campagne pubblicitarie e sistemi commerciali, così da costruire uno storico autonomo e produrre analisi personalizzate.
L'utilità emerge quando i report dei singoli strumenti non bastano più: occorre confrontare più anni di rendimento SEO, incrociare visibilità e comportamento sul sito oppure aggiornare ogni mese decine di dashboard. BigQuery offre la base tecnica per farlo. La completezza dell'archivio dipende però dalle esportazioni disponibili, dalla qualità del tracciamento e dalla continuità dei trasferimenti. La guida chiarisce come configurarlo, quali limiti presenta e quanto può costare, con query SQL ed esempi applicativi.
In questo approfondimento
- Cos'è Google BigQuery e come funziona
- Perché usare BigQuery nel digital marketing
- Come iniziare a usare BigQuery
- Come collegare GA4 a BigQuery
- Come esportare Search Console in BigQuery
- Come integrare altre fonti di marketing
- Come interrogare i dati con SQL
- Come unire GA4 e Search Console e applicare i risultati alla SEO
- Quanto costa Google BigQuery
- Vantaggi, svantaggi, qualità e sicurezza dei dati
- Differenze fra BigQuery, GA4, Search Console e Looker Studio
- Quando conviene adottare BigQuery
- Domande frequenti
- Conclusioni
- Fonti e documentazione
Cos'è Google BigQuery e come funziona
BigQuery fa parte di Google Cloud ed è un servizio di analisi dei dati completamente gestito. Il modello serverless affida a Google l'infrastruttura, l'assegnazione delle risorse di calcolo e molte attività di manutenzione. L'organizzazione mantiene invece la responsabilità dei dati che carica, delle autorizzazioni e delle interrogazioni che esegue. La separazione fra archiviazione e calcolo consente di conservare un dataset anche quando nessuno esegue query, e di attivare risorse di elaborazione quando serve.
Che cosa distingue un data warehouse da un database tradizionale
Un database transazionale registra le operazioni quotidiane di un'applicazione: ordini, clienti, disponibilità di magazzino. Un data warehouse risponde a domande diverse. Quante vendite produce un canale nel trimestre? Quali categorie perdono traffico rispetto all'anno precedente? Come cambia il rendimento di una campagna dopo una modifica alle pagine di destinazione?
BigQuery supporta interrogazioni su milioni di righe attraverso GoogleSQL, il dialetto SQL della piattaforma. La memorizzazione colonnare favorisce le analisi che leggono soltanto alcuni campi di tabelle molto ampie. La query seleziona le colonne, applica filtri e produce aggregazioni; non richiede l'esportazione preventiva di tutte le righe in Excel. Il vantaggio non consiste nella semplice quantità di spazio, ma nella possibilità di eseguire analisi ripetibili su dati che provengono da sistemi diversi.
Progetti, dataset, tabelle e viste
Il progetto Google Cloud identifica il contesto amministrativo, compresi permessi e fatturazione. Al suo interno, un dataset raccoglie tabelle e viste nella localizzazione scelta. Le tabelle contengono righe e colonne; una vista conserva la definizione SQL di un risultato e lo rende interrogabile come un oggetto logico. Nel caso di GA4, le tabelle giornaliere assumono nomi come events_20261117. Search Console utilizza tabelle di rendimento che crescono nel tempo attraverso nuove partizioni.
searchdata_url_impression
ExportLog
events_intraday_YYYYMMDD
sessioni_organiche_per_url
Per conservare la provenienza delle informazioni, conviene distinguere le tabelle originali da quelle derivate. Una modifica alla regola che normalizza gli URL, per esempio, può richiedere il ricalcolo dei report senza alterare l'esportazione sorgente. Questo criterio rende più semplici i controlli e le correzioni successive.
Perché usare BigQuery nel digital marketing
Un team può trovare i clic organici in Search Console, le sessioni e gli eventi chiave in GA4, gli investimenti in Google Ads e i contratti conclusi nel CRM. Ciascun sistema utilizza un proprio schema, una frequenza di aggiornamento e criteri specifici per attribuire i risultati. BigQuery permette di trattare queste informazioni in uno stesso ambiente analitico, ma non rende automaticamente equivalenti le metriche.
Conservare i dati storici di SEO e analytics
Search Console rende normalmente consultabili fino a 16 mesi di dati sul rendimento attraverso i report. Le esportazioni manuali e la Search Analytics API introducono ulteriori limiti di accesso alle righe. Un bulk export giornaliero verso BigQuery permette di costruire uno storico che supera questa finestra, a condizione che il trasferimento inizi per tempo e che il progetto non cancelli le partizioni necessarie.
GA4 distingue la conservazione di alcune informazioni granulari disponibili nelle Esplorazioni dalla disponibilità dei report aggregati standard. L'esportazione degli eventi verso BigQuery crea un archivio con regole proprie di accesso e conservazione. Non ricostruisce, però, gli eventi di un periodo precedente al collegamento. Per chi vuole studiare l'evoluzione di un sito su più anni, la data di attivazione delle esportazioni costituisce quindi una scelta operativa rilevante.
Costruire indicatori condivisi e report coerenti
Con le fonti già presenti nel warehouse, una query può aggregare ogni mese i clic per URL; un'altra può ricostruire le sessioni organiche e una terza può preparare i risultati per una dashboard. La struttura riduce la necessità di importare manualmente nuovi CSV a ogni aggiornamento. Serve comunque un dizionario delle metriche: «lead», «sessione organica» e «conversione» devono avere una definizione comprensibile anche a chi consulta il report.
Una consulenza Web Analytics e configurazione GA4 affronta proprio la qualità della misurazione e la coerenza degli eventi. Un evento duplicato, un parametro mancante o un errore di consenso producono dati problematici anche dopo il trasferimento nel warehouse. La verifica del tracciamento viene prima della costruzione della dashboard.
Come iniziare a usare Google BigQuery
La prima configurazione richiede poche operazioni, ma progetto, regione e autorizzazioni influenzano l’intero flusso dei dati. Un’impostazione corretta evita successive migrazioni e problemi nel collegamento delle fonti.
Creare il progetto e scegliere la localizzazione
La configurazione parte da Google Cloud Console. Si crea un progetto, si annota il relativo ID — diverso dal nome descrittivo e dal numero del progetto — e si apre BigQuery Studio. Da qui si può creare un dataset e scegliere una localizzazione, per esempio la multiregione EU oppure una specifica regione europea. La localizzazione va scelta prima di attivare le esportazioni: molte interrogazioni richiedono che i dataset coinvolti risiedano nella stessa localizzazione BigQuery.
La sigla EU non equivale automaticamente a europe-west1, anche se entrambe fanno riferimento a infrastrutture europee. Una normale query SQL non può unire liberamente tabelle che risiedono in localizzazioni incompatibili. Chi progetta l'archivio deve valutare insieme residenza dei dati, restrizioni organizzative e trasferimenti fra servizi. Una localizzazione europea non garantisce, da sola, la conformità al GDPR.
Prima di collegare una proprietà GA4 o Search Console conviene definire un criterio unico di localizzazione per le tabelle che le query devono interrogare insieme. Quando i dataset risiedono in sedi incompatibili, il team deve organizzare un trasferimento o una copia secondo le regole applicabili; cambiare un parametro nell'editor SQL non supera questo vincolo.
Permessi IAM e fatturazione
Google Cloud utilizza IAM, acronimo di Identity and Access Management, per assegnare i privilegi. Conviene separare gli utenti che consultano i report dagli account tecnici che scrivono nelle tabelle. Il progetto può inoltre disporre di un budget, notifiche di spesa e quote di elaborazione. Gli avvisi di budget non interrompono automaticamente tutte le operazioni a pagamento; per limitare l'esposizione servono anche restrizioni sulle query e sulle risorse.
BigQuery Sandbox e quota gratuita ordinaria
La Sandbox permette di provare BigQuery senza associare un account di fatturazione. Offre un limite di archiviazione di 10 GiB e una quota di 1 TiB di query elaborate al mese; le tabelle e le viste scadono automaticamente dopo 60 giorni. La Sandbox limita inoltre lo streaming e altre funzioni operative. È adatta agli esercizi SQL, meno alla conservazione pluriennale dello storico SEO.
Un progetto ordinario con fatturazione attiva può comunque usufruire del livello gratuito previsto da BigQuery. Attivare la fatturazione non equivale a pagare un canone fisso per il semplice possesso del progetto. I consumi eccedenti e gli eventuali servizi aggiuntivi determinano la spesa.
Come collegare Google Analytics 4 a BigQuery
GA4 offre un collegamento nativo che trasferisce nel dataset BigQuery i dati evento della proprietà. L'esportazione permette di analizzare singoli eventi, parametri, identificativi disponibili e sorgenti di traffico secondo il relativo schema. La granularità aumenta, ma l'archivio non contiene automaticamente tutte le elaborazioni che l'interfaccia Analytics applica ai propri report.
Configurare il collegamento dalla proprietà GA4
In Amministrazione, nella sezione dei collegamenti ai prodotti, si seleziona BigQuery e si sceglie il progetto Google Cloud di destinazione. Servono il ruolo Editor sulla proprietà GA4 e i permessi cloud richiesti dalla procedura. Il configuratore permette di selezionare flussi di dati, eventi da escludere e modalità di esportazione. Dopo il salvataggio, il controllo iniziale riguarda il dataset analytics_IDPROPRIETA, l'arrivo delle tabelle e il volume degli eventi.
Chi deve progettare gli eventi e i parametri prima dell'esportazione può partire da un servizio di consulenza per il tag management e Google Tag Manager. Una nomenclatura coerente degli eventi semplifica le interrogazioni SQL e il confronto dei risultati fra più siti.
Esportazione giornaliera, streaming e limiti
| Aspetto | Giornaliera | Streaming |
|---|---|---|
| Tabella | events_YYYYMMDD |
events_intraday_YYYYMMDD |
| Disponibilità | Dopo il trasferimento giornaliero | Durante la giornata, con aggiornamenti continui |
| Uso consigliato | Analisi storiche consolidate | Controlli vicini al tempo reale |
| Limiti e completezza | 1 milione di eventi al giorno per l'export batch delle proprietà standard | Best effort: possibili dati incompleti e limiti nelle informazioni di attribuzione |
| Costi | Archiviazione e interrogazioni | Anche costo di acquisizione streaming |
La modalità streaming non adotta la stessa soglia giornaliera di un milione di eventi, ma Google non garantisce la completezza dei dati intraday. Quando GA4 completa la tabella giornaliera, elimina la corrispondente tabella intraday. Per i report storici conviene interrogare events_YYYYMMDD e non sommare le due tipologie di tabella.
La proprietà standard può superare il limite dell'esportazione giornaliera e ricevere comunicazioni sulla necessità di ridurre gli eventi esportati. La soglia riguarda il trasferimento batch, non il numero complessivo di eventi che la proprietà può raccogliere. Per lo streaming Google indica, come riferimento, 0,05 USD per GB trasferito, oltre agli altri costi BigQuery applicabili.
Perché le tabelle GA4 cambiano nei giorni successivi
GA4 può aggiornare una tabella giornaliera per includere eventi che arrivano in ritardo, entro una finestra che comprende il giorno dell'evento e i due giorni successivi. Un report automatico che consolida definitivamente la giornata appena terminata rischia quindi di sottostimare i conteggi. Una strategia pratica consiste nel rielaborare anche le giornate recenti e nel distinguere dati provvisori da dati consolidati.
Come leggere eventi, sessioni e sorgenti di traffico
Le tabelle contengono campi semplici, come event_name ed event_date, e strutture annidate. Il campo event_params può ospitare page_location e ga_session_id. SQL usa UNNEST per estrarne i valori. Il conteggio di page_view misura le occorrenze dell'evento: non rappresenta automaticamente il numero di sessioni o di persone.
Per l'attribuzione occorre distinguere il campo traffic_source, relativo alla prima acquisizione dell'utente, dai dati della sessione presenti in session_traffic_source_last_click, ove disponibili. Anche collected_traffic_source risponde a uno scopo diverso: registra informazioni sulla sorgente raccolte con l'evento. Mescolare questi ambiti porta a confronti errati fra report e può falsare le analisi di conversione.
La ricostruzione delle sessioni richiede inoltre attenzione agli identificativi. Il parametro ga_session_id non identifica da solo una sessione in modo univoco fra tutti gli utenti: per un'analisi dimostrativa si può combinarlo con user_pseudo_id, quando entrambi sono disponibili. Il consenso e le scelte di raccolta possono rendere assenti alcuni identificativi; in questi casi la ricostruzione non sarà esaustiva.
I dati aggiuntivi di Google Signals non transitano nel BigQuery Export. Per questo le identificazioni cross-device e alcune elaborazioni disponibili nei report GA4 possono differire dai dati evento esportati. Gli identificativi osservati non ricostruiscono automaticamente tutte le persone: il confronto tra utenti richiede definizioni identiche e una verifica delle impostazioni della proprietà.
Come esportare i dati di Google Search Console in BigQuery
Search Console mette a disposizione il bulk data export, che trasferisce quotidianamente i dati sul rendimento nel progetto Google Cloud. Per siti con molte pagine e query, questo sistema offre un livello di dettaglio superiore alle esportazioni ordinarie e alla Search Analytics API, che non garantisce il recupero di tutte le combinazioni disponibili. Le query anonimizzate rimangono protette: il trasferimento non permette di recuperare il testo che Google nasconde per ragioni di privacy.
Configurazione: account, API e dataset
Il responsabile della configurazione deve avere la proprietà necessaria in Search Console e disporre di un progetto Google Cloud con fatturazione valida. Nella sezione API e servizi di Cloud Console si abilitano BigQuery API e BigQuery Storage API. Nell'area IAM si concede al service account search-console-data-export@system.gserviceaccount.com il ruolo bigquery.jobUser e il ruolo bigquery.dataEditor, secondo la procedura ufficiale.
In Search Console si apre Impostazioni → Esportazione collettiva dei dati, si inserisce l'ID del progetto, si definisce il nome del dataset e si sceglie la localizzazione. Il nome del dataset inizia con searchconsole; proprietà differenti richiedono dataset distinti. Google avvia il primo trasferimento entro 48 ore dalla configurazione corretta. La creazione del collegamento non prova, da sola, che i dati siano già arrivati: serve un controllo nelle tabelle BigQuery.
Quali dati contengono le tabelle Search Console
| Tabella | Livello e contenuto | Utilizzo |
|---|---|---|
searchdata_site_impression |
Rendimento aggregato per proprietà; include sum_top_position |
Query e visibilità complessiva del sito |
searchdata_url_impression |
Rendimento per URL; include url e sum_position |
Pagine, query e opportunità di ottimizzazione |
ExportLog |
Data, tabella, versione e orario delle esportazioni riuscite | Controllo della continuità dello storico |
Le tabelle di rendimento comprendono clic, impressioni e dimensioni come paese, dispositivo, query e tipo di ricerca. Una combinazione di dimensioni può occupare più righe: per questo le metriche richiedono aggregazioni tramite SUM(). La posizione media segue una formula specifica e parte da valori con base zero, come mostrano le query più avanti.
Come controllare le esportazioni e scoprire le giornate mancanti
ExportLog registra soltanto le esportazioni riuscite. Il campo namespace identifica la tabella, data_date il giorno dei dati e publish_time il momento del trasferimento. epoch_version cresce se Search Console pubblica una revisione dei dati di una giornata. L'assenza di una riga nel registro non spiega da sola la causa dell'errore: per quella servono lo stato in Search Console e, se necessario, Cloud Logging.
La query seguente genera il calendario di ottobre 2026 e controlla esplicitamente la presenza di entrambe le tabelle di rendimento. Non conta altri eventuali namespace e segnala le date per le quali il registro non documenta entrambe le esportazioni. Va adattata al periodo effettivamente coperto dal collegamento e non utilizzata per interpretare come errori i giorni futuri o non ancora disponibili.
WITH calendario AS (
  SELECT giorno
  FROM UNNEST(GENERATE_DATE_ARRAY(
    DATE '2026-10-01', DATE '2026-10-31'
  )) AS giorno
), registro AS (
  SELECT
    data_date,
    COUNT(DISTINCT IF(
      namespace IN (
        'searchdata_site_impression',
        'searchdata_url_impression'
      ),
      namespace,
      NULL
    )) AS tabelle_esportate,
    MAX(epoch_version) AS ultima_versione
  FROM `progetto-marketing.searchconsole_sito.ExportLog`
  WHERE data_date BETWEEN DATE '2026-10-01'
                      AND DATE '2026-10-31'
  GROUP BY data_date
)
SELECT
  c.giorno,
  COALESCE(r.tabelle_esportate, 0) AS tabelle_esportate,
  r.ultima_versione
FROM calendario AS c
LEFT JOIN registro AS r
  ON c.giorno = r.data_date
WHERE COALESCE(r.tabelle_esportate, 0) < 2
ORDER BY c.giorno;
Il risultato individua le giornate che richiedono una verifica. Una data recente può risultare assente perché Search Console non ha ancora completato il trasferimento; una data passata può indicare un errore o un problema di copertura. Il controllo non sostituisce l'esame delle tabelle e dello stato dell'esportazione, ma permette di individuare rapidamente le possibili lacune.
In caso di errore persistente, Search Console riprova per circa una settimana a trasferire i dati di una giornata. Dopo tale finestra può rinunciare al recupero; dopo circa un mese di errori ripetuti può interrompere del tutto l'esportazione. Il team deve quindi verificare regolarmente i messaggi e correggere tempestivamente i problemi di permessi, quote o schema.
Come evitare cancellazioni accidentali dello storico
Le tabelle del bulk export non prevedono una scadenza automatica per impostazione predefinita, salvo eventuali politiche globali del progetto. Se occorre limitare il periodo di conservazione, Google raccomanda di utilizzare la scadenza delle partizioni, con una durata di almeno 14 giorni per non ostacolare i trasferimenti. Una scadenza sull'intera tabella elimina tutti i dati al raggiungimento della data prevista. Inoltre, modificare lo schema delle tabelle di esportazione può interrompere il servizio: è preferibile eseguire le trasformazioni in tabelle separate.
È possibile recuperare i dati precedenti all'attivazione?
Il bulk export non avvia un recupero retroattivo completo. I report di Search Console rendono normalmente disponibile uno storico fino a 16 mesi. La Search Analytics API permette di recuperarne una parte, con un massimo di 25.000 righe per richiesta e senza garanzia di completezza neppure attraverso più richieste paginate. Il recupero può alimentare tabelle dedicate, distinte da quelle del bulk export, purché la procedura documenti origine, copertura e differenze di granularità.
Un archivio già avviato semplifica la valutazione degli interventi sulle pagine. Una consulenza SEO basata sull’analisi delle prestazioni organiche può mettere in relazione le variazioni di visibilità con modifiche tecniche ed editoriali documentate. I dati descrivono il cambiamento; l'analisi deve ancora stabilirne le cause plausibili.
Come integrare altre fonti di marketing in BigQuery
GA4 e Search Console coprono una parte dell’attività digitale. BigQuery può ricevere anche dati pubblicitari e commerciali tramite connettori, API e integrazioni, ciascuno con frequenze, costi e vincoli diversi.
Google Ads, Meta Ads e i connettori disponibili
BigQuery Data Transfer Service offre connettori per alcune piattaforme, tra cui Google Ads e Facebook Ads. Il servizio permette di configurare trasferimenti ricorrenti, ma ogni connettore espone specifiche tabelle, frequenze e condizioni economiche. Per le campagne Google Ads può essere utile acquisire dati relativi a spesa, clic, impressioni e conversioni, con la consapevolezza che i valori attribuiti dalla piattaforma possono differire da GA4 e CRM.
Le spese e le conversioni pubblicitarie entrano nel warehouse come dati operativi. Una consulenza per la gestione delle campagne Google Ads può utilizzare queste informazioni per confrontare investimenti e risultati commerciali. Le condizioni economiche dei connettori variano: oltre ai costi BigQuery possono comparire tariffe di trasferimento o servizi esterni.
CRM, e-commerce e procedure personalizzate
Un gestionale o un CRM può inviare lead, opportunità, ordini e ricavi attraverso API, file o procedure di integrazione dedicate. Lo schema deve prevedere chiavi di collegamento affidabili e una gestione rigorosa dei dati personali. Senza un identificativo condiviso, la presenza di informazioni nello stesso warehouse non consente di ricostruire con certezza il rapporto fra una visita e un acquisto.
Le integrazioni possono richiedere processi intermedi che trasferiscono e controllano i dati dai sistemi aziendali. Nel caso di sviluppo di applicazioni web personalizzate, per esempio, le API possono alimentare tabelle di ordini o opportunità commerciali. Gli identificativi condivisi consentono join affidabili soltanto se le fonti li raccolgono in modo consistente.
Un progetto di consulenza sulla lead generation e sulla qualità dei contatti può utilizzare questi dati per distinguere richieste ricevute, opportunità qualificate e contratti conclusi. La conversione commerciale richiede dati del CRM: un evento registrato sul sito non documenta da solo l'esito della trattativa.
Per distinguere le trasformazioni, le procedure ETL (extract, transform, load) modificano i dati prima del caricamento; i flussi ELT (extract, load, transform) caricano i dati prima delle elaborazioni nel warehouse. Nei progetti di marketing, conservare una copia delle informazioni originali in un livello separato facilita audit e correzioni. La successiva tabella analitica può contenere URL normalizzati, date coerenti e indicatori già calcolati.
Come interrogare i dati di BigQuery con SQL
L'editor di BigQuery Studio consente di selezionare campi con SELECT, indicare le tabelle tramite FROM, limitare i dati con WHERE e aggregare i risultati con GROUP BY. Le interrogazioni riportate qui usano nomi dimostrativi: il lettore deve sostituire progetto e dataset con gli identificativi effettivi. Prima dell'esecuzione conviene verificare lo schema delle tabelle e la stima dei byte elaborati.
Query Search Console: clic, impressioni, CTR e posizione per URL
Questa query estrae i clic da Google Search per pagina nel mese di ottobre 2026. Calcola il CTR sui totali e la posizione media con la somma delle posizioni divisa per le impressioni, più uno. La tabella searchdata_url_impression utilizza infatti il campo sum_position, con base zero.
SELECT
  url,
  SUM(clicks) AS clic,
  SUM(impressions) AS impressioni,
  ROUND(
    SAFE_DIVIDE(SUM(clicks), SUM(impressions)) * 100,
    2
  ) AS ctr_percentuale,
  ROUND(
    SAFE_DIVIDE(SUM(sum_position), SUM(impressions)) + 1,
    2
  ) AS posizione_media
FROM `progetto-marketing.searchconsole_sito.searchdata_url_impression`
WHERE data_date BETWEEN DATE '2026-10-01'
                    AND DATE '2026-10-31'
  AND LOWER(search_type) = 'web'
GROUP BY url
ORDER BY clic DESC;
Il risultato identifica gli URL con più clic registrati da Search Console. Non indica le sessioni organiche di GA4: i due sistemi non misurano la stessa unità. Se l'analisi richiede il totale del sito anziché quello degli URL, conviene utilizzare searchdata_site_impression e il campo sum_top_position per la posizione media.
Query GA4: conteggiare visualizzazioni e contatti
Per GA4 è possibile interrogare le tabelle giornaliere con un suffisso di data. L'esempio conta gli eventi page_view e generate_lead. Funziona se la proprietà registra effettivamente l'evento di lead con quel nome.
SELECT
  PARSE_DATE('%Y%m%d', event_date) AS giorno,
  COUNTIF(event_name = 'page_view') AS visualizzazioni,
  COUNTIF(event_name = 'generate_lead') AS eventi_contatto
FROM `progetto-marketing.analytics_123456789.events_*`
WHERE _TABLE_SUFFIX BETWEEN '20261001' AND '20261031'
  AND event_name IN ('page_view', 'generate_lead')
GROUP BY giorno
ORDER BY giorno;
Il conteggio degli eventi generate_lead non equivale necessariamente al numero di lead unici o qualificati. Per comprendere la pagina associata a un evento web, occorre estrarre i parametri annidati, per esempio tramite UNNEST(event_params). Anche in questo caso il sistema deve distinguere la pagina di un evento dalla pagina iniziale di una sessione.
Come ridurre la quantità di dati elaborati
Nel modello on-demand, il costo delle query dipende dai byte elaborati. Per le tabelle GA4 con suffisso di data conviene limitare _TABLE_SUFFIX; per le tabelle partizionate conviene filtrare le relative colonne di partizione. Selezionare soltanto i campi necessari evita scansioni inutili. Una semplice clausola LIMIT 100 su una tabella non garantisce una riduzione dei byte letti: limita il risultato, non necessariamente il lavoro di elaborazione.
BigQuery Studio mostra una stima preliminare della lettura; un dry run permette di verificarla senza lanciare l'analisi. La configurazione maximumBytesBilled impone un limite ai byte fatturabili della singola query. Per i report ricorrenti conviene valutare viste, tabelle aggregate e query pianificate, con controlli sui job falliti.
Come unire GA4 e Search Console e applicare i risultati alla SEO
Unire due fonti è più difficile che leggerle separatamente. Search Console attribuisce le metriche a URL che possono corrispondere alla versione canonica scelta da Google; GA4 registra indirizzi sui quali il sistema di tracciamento funziona. Parametri, slash finali, domini alternativi e pagine non HTML creano differenze. Prima del JOIN, entrambe le fonti devono avere la stessa granularità e una chiave URL coerente.
Una query per confrontare clic SEO e sessioni organiche per pagina
L'esempio seguente produce un confronto mensile per URL: da Search Console ricava clic e impressioni della Ricerca web; da GA4 conta sessioni osservabili con prima visualizzazione di pagina e sorgente google / organic. La query aggrega ciascuna sorgente prima di unirla all'altra, così evita di moltiplicare le metriche attraverso un join fra righe evento e righe di Search Console.
L'esempio usa il record session_traffic_source_last_click.cross_channel_campaign, presente negli schemi GA4 recenti. Per dataset più vecchi occorre verificare la disponibilità di questo record e adottare una ricostruzione compatibile. I filtri escludono sessioni senza identificativi necessari: il risultato GA4 può quindi risultare inferiore ai report dell'interfaccia.
WITH gsc AS (
  SELECT
    REGEXP_REPLACE(
      REGEXP_REPLACE(url, r'[?#].*$', ''), r'/$', ''
    ) AS pagina,
    SUM(clicks) AS clic_gsc,
    SUM(impressions) AS impressioni_gsc
  FROM `progetto-marketing.searchconsole_sito.searchdata_url_impression`
  WHERE data_date BETWEEN DATE '2026-10-01'
                      AND DATE '2026-10-31'
    AND LOWER(search_type) = 'web'
    AND url IS NOT NULL
  GROUP BY pagina
),
eventi_ga4 AS (
  SELECT
    event_date,
    event_timestamp,
    user_pseudo_id,
    (SELECT ep.value.int_value
     FROM UNNEST(event_params) AS ep
     WHERE ep.key = 'ga_session_id') AS id_sessione,
    (SELECT ep.value.string_value
     FROM UNNEST(event_params) AS ep
     WHERE ep.key = 'page_location') AS pagina_evento,
    session_traffic_source_last_click
      .cross_channel_campaign.source AS sorgente,
    session_traffic_source_last_click
      .cross_channel_campaign.medium AS mezzo
  FROM `progetto-marketing.analytics_123456789.events_*`
  WHERE _TABLE_SUFFIX BETWEEN '20260930' AND '20261031'
    AND event_name = 'page_view'
    AND user_pseudo_id IS NOT NULL
),
prime_pagine AS (
  SELECT *
  FROM eventi_ga4
  WHERE id_sessione IS NOT NULL
    AND pagina_evento IS NOT NULL
  QUALIFY ROW_NUMBER() OVER (
    PARTITION BY user_pseudo_id, id_sessione
    ORDER BY event_timestamp
  ) = 1
),
ga4 AS (
  SELECT
    REGEXP_REPLACE(
      REGEXP_REPLACE(pagina_evento, r'[?#].*$', ''),
      r'/$', ''
    ) AS pagina,
    COUNT(*) AS sessioni_google_organic_osservabili
  FROM prime_pagine
  WHERE event_date BETWEEN '20261001' AND '20261031'
    AND LOWER(sorgente) = 'google'
    AND LOWER(mezzo) = 'organic'
  GROUP BY pagina
)
SELECT
  gsc.pagina,
  gsc.clic_gsc,
  gsc.impressioni_gsc,
  ga4.sessioni_google_organic_osservabili,
  CASE
    WHEN ga4.pagina IS NULL THEN 'Nessun match GA4 filtrato'
    ELSE 'Match nei dati GA4 filtrati'
  END AS stato_corrispondenza
FROM gsc
LEFT JOIN ga4 USING (pagina)
ORDER BY gsc.clic_gsc DESC;
La query costituisce un modello didattico, non una replica esatta dei report GA4. Individua la prima page_view osservabile per la combinazione di identificativi disponibili: se il tracciamento perde la prima visualizzazione, la pagina risultante può essere successiva a quella di ingresso. Il confronto usa le sessioni con fonte e mezzo google / organic disponibili nello schema indicato; il conteggio esclude quelle prive di identificativi. La normalizzazione rimuove query string e slash finale, scelta inadatta a siti nei quali i parametri distinguono contenuti diversi.
Un progetto che gestisce redirect, URL canonici e varianti linguistiche dovrebbe mantenere una tabella di corrispondenza URL: ogni indirizzo osservato da GA4 può così collegarsi, tramite regole documentate, all'URL che il report SEO utilizza come riferimento. Il semplice taglio dei parametri non risolve varianti di dominio o canoniche differenti.
La query conserva NULL quando non trova sessioni GA4 associate a una pagina e aggiunge uno stato di corrispondenza esplicito. Un valore assente significa che i filtri e la chiave non trovano dati corrispondenti: non dimostra che la pagina abbia ricevuto zero sessioni. Anche una corrispondenza esistente richiede verifiche sui livelli di copertura dei tracciamenti.
Search Console attribuisce data_date al giorno secondo l’ora del Pacifico; GA4 assegna event_date secondo il fuso della proprietà. La query seleziona anche il 30 settembre dalle tabelle GA4 per considerare una prima visualizzazione associata a una sessione che attraversa la mezzanotte, ma applica la selezione finale alle sessioni il cui evento di prima pagina osservato ricade in ottobre. Questo accorgimento non riallinea i due calendari: il report mette a confronto lo stesso mese nominale, con possibili differenze ai confini temporali. Un confronto giornaliero rigoroso richiede un’analisi specifica dei fusi e della granularità disponibile.
Il risultato serve a mettere le misure una accanto all'altra, non a calcolare un tasso di conversione dei clic in sessioni. Le visite che non consentono il tracciamento, i filtri, l'attribuzione e la logica delle URL canoniche spiegano parte delle differenze. Inoltre, l'unione per pagina non permette di associare una singola query di ricerca a una conversione GA4.
Per valutare la qualità dell'unione si può misurare la percentuale di pagine con match sul totale degli URL presenti nel report GSC e analizzare separatamente quelli senza corrispondenza. Una percentuale elevata non dimostra comunque equivalenza tra clic e sessioni: descrive soltanto quante chiavi trovano una corrispondenza nei dati filtrati.
Un caso applicativo: selezionare gli articoli da aggiornare
Si consideri un portale editoriale ipotetico con 15.000 articoli. Il team dispone di dodici mesi di dati Search Console e delle tabelle GA4 corrispondenti. Confronta due intervalli di 91 giorni: dal 1° aprile al 30 giugno 2026 e dal 1° luglio al 29 settembre 2026. Seleziona le pagine con almeno 1.000 impressioni nel secondo periodo e calcola la variazione dei clic. La tabella che segue utilizza numeri inventati esclusivamente per illustrare il criterio.
Il controllo può orientare anche le campagne SEO dedicate al posizionamento su Google, purché ogni segnalazione venga verificata sul contenuto e sui risultati di ricerca. Una perdita di clic non dimostra da sola che una pagina necessiti di una riscrittura.
| Pagina | Clic periodo A | Clic periodo B | Variazione | Impressioni B |
|---|---|---|---|---|
| Articolo A | 1.850 | 1.230 | −33,5% | 24.600 |
| Articolo B | 940 | 1.410 | +50,0% | 18.300 |
| Articolo C | 2.100 | 1.980 | −5,7% | 42.100 |
Il seguente esempio produce la tabella di confronto direttamente dai dati Search Console. La soglia minima di impressioni evita di trattare come prioritarie pagine con volumi trascurabili. La percentuale resta NULL quando il periodo A registra zero clic: una variazione percentuale in quel caso non è definita.
SELECT
  url,
  SUM(IF(data_date BETWEEN DATE '2026-04-01'
                       AND DATE '2026-06-30', clicks, 0)) AS clic_a,
  SUM(IF(data_date BETWEEN DATE '2026-07-01'
                       AND DATE '2026-09-29', clicks, 0)) AS clic_b,
  SUM(IF(data_date BETWEEN DATE '2026-07-01'
                       AND DATE '2026-09-29', impressions, 0)) AS impressioni_b,
  ROUND(SAFE_DIVIDE(
    SUM(IF(data_date BETWEEN DATE '2026-07-01'
                         AND DATE '2026-09-29', clicks, 0))
    - SUM(IF(data_date BETWEEN DATE '2026-04-01'
                         AND DATE '2026-06-30', clicks, 0)),
    NULLIF(SUM(IF(data_date BETWEEN DATE '2026-04-01'
                                   AND DATE '2026-06-30', clicks, 0)), 0)
  ) * 100, 1) AS variazione_clic_percento
FROM `progetto-marketing.searchconsole_sito.searchdata_url_impression`
WHERE data_date BETWEEN DATE '2026-04-01' AND DATE '2026-09-29'
  AND LOWER(search_type) = 'web'
  AND url IS NOT NULL
GROUP BY url
HAVING impressioni_b >= 1000
ORDER BY variazione_clic_percento IS NULL,
         variazione_clic_percento ASC;
L'articolo A entra nella lista di verifica perché perde circa un terzo dei clic e mantiene una quantità significativa di impressioni. Il team esamina anche posizioni, CTR, query prevalenti, modifiche del contenuto e andamento della domanda. L'articolo B cresce e può suggerire quali sezioni o argomenti meritano ulteriori approfondimenti. La lieve perdita dell'articolo C non basta da sola a giustificare una riscrittura.
Quando il problema riguarda ciò che accade dopo il clic, una consulenza CRO per ottimizzare le conversioni può analizzare moduli, percorsi e punti di abbandono. Gli eventi e le verifiche UX aiutano a formulare ipotesi sul percorso successivo all’atterraggio; i dati SEO servono a selezionare le pagine da esaminare.
Le metriche GA4 possono aggiungere informazioni su sessioni, interazioni ed eventi chiave delle pagine selezionate. La valutazione deve distinguere il traffico che arriva sulla pagina dalle visualizzazioni successive all'interno della stessa visita. Il ruolo del warehouse consiste nel produrre una shortlist coerente e verificabile; il giudizio editoriale richiede ancora l'analisi delle SERP e del contenuto effettivo.
Automatizzare l'analisi senza perdere il controllo
La procedura può generare ogni mese una tabella riepilogativa e alimentare una dashboard. Conviene registrare la data dell'ultima esportazione, il periodo incluso, il numero di righe e la versione delle trasformazioni. Se una fonte presenta giornate mancanti, il sistema dovrebbe segnalarlo invece di mostrare una variazione apparentemente attendibile. Il controllo sulla disponibilità dei dati diventa parte del report, non un'attività separata che il team esegue soltanto dopo un'anomalia.
Quanto costa Google BigQuery? Prezzi e piano gratuito
BigQuery distingue i costi di archiviazione da quelli delle interrogazioni. Il modello on-demand calcola il prezzo delle query sui byte elaborati; altre opzioni utilizzano capacità di calcolo dedicata. Per il reporting SEO di piccole o medie dimensioni, il modello on-demand rappresenta spesso il punto di partenza più semplice da valutare. La scelta effettiva dipende da volumi, frequenza delle elaborazioni e localizzazione delle risorse.
Quote gratuite, archiviazione e query
Alla verifica del 18 novembre 2026, BigQuery prevede 10 GiB di archiviazione e 1 TiB di elaborazione on-demand al mese nel livello gratuito, secondo le condizioni applicabili. Il prezzo di riferimento oltre la soglia può partire da 6,25 USD per TiB elaborato. L'archiviazione logica attiva ha una tariffa distinta; le partizioni che non subiscono modifiche per 90 giorni consecutivi possono rientrare nella tariffazione a lungo termine, più economica.
Le tariffe dipendono dalla localizzazione e dal modello scelto; le quote gratuite possono inoltre riguardare l’insieme dei progetti associati allo stesso account di fatturazione. Un archivio che cresce di pochi gigabyte al mese può produrre una spesa cloud contenuta, mentre query frequenti che rileggono ogni volta tutte le colonne possono incidere maggiormente. La spesa non dipende direttamente dal numero di righe visualizzate nel risultato.
Tre simulazioni di costo mensile
Le simulazioni seguenti assumono, esclusivamente per il calcolo, 6,25 USD per TiB di dati elaborati oltre il primo TiB e 0,023 USD per GiB/mese di archiviazione logica attiva oltre i primi 10 GiB. Il riferimento è una tariffazione di tipo us-central1; un progetto europeo richiede la verifica del relativo listino. I GiB indicano una consistenza media fatturabile nell’arco del mese, mentre i TiB rappresentano dati elaborati dalle query, non righe restituite. La tabella presuppone la disponibilità dell’intera quota gratuita sul relativo account di fatturazione.
| Scenario | Archivio | Query al mese | Archiviazione | Query | Totale |
|---|---|---|---|---|---|
| Piccolo sito SEO | 8 GiB | 0,3 TiB | 0 USD | 0 USD | 0 USD |
| E-commerce con analytics | 40 GiB | 2 TiB | 0,69 USD | 6,25 USD | 6,94 USD |
| Portale con più sorgenti | 200 GiB | 10 TiB | 4,37 USD | 56,25 USD | 60,62 USD |
Il calcolo non include imposte, streaming, connettori a pagamento, trasferimenti particolari, altri servizi Google Cloud o condizioni tariffarie differenti. I prezzi non rappresentano un preventivo per un progetto reale. La modalità streaming GA4 prevede inoltre una tariffa indicativa di 0,05 USD per GB trasferito; il connettore di Google Ads e quello di Facebook Ads possono avere condizioni economiche diverse.
Il costo del progetto supera spesso la fattura cloud
Un data warehouse operativo richiede progettazione delle tabelle, configurazione degli accessi, sviluppo o attivazione dei connettori, verifica degli eventi e manutenzione dei job. Per un piccolo sito, queste attività possono avere un costo superiore a quello dell'archiviazione e delle query. Per valutare la convenienza occorre distinguere il consumo BigQuery dal costo di implementazione e gestione, oltre al tempo che il sistema fa risparmiare nelle attività ricorrenti.
Se il warehouse integra costi pubblicitari, contatti qualificati e risultati di vendita, la consulenza di performance marketing basata sui risultati può contribuire a definire le metriche necessarie. Il costo per acquisizione cambia significato se il denominatore rappresenta un lead, un cliente oppure un ordine.
Controllare le spese prima di eseguire le analisi
Le query con filtri appropriati, tabelle partizionate e selezione delle colonne riducono spesso i byte elaborati. BigQuery mette a disposizione stime preliminari, controlli tramite dry run e limiti massimi ai byte fatturabili per query. I budget Google Cloud aiutano a monitorare la spesa, ma gli avvisi non costituiscono un interruttore generale. Per un sistema con più fonti conviene monitorare separatamente costi di archiviazione, interrogazioni, trasferimenti e strumenti esterni.
Vantaggi, svantaggi, qualità e sicurezza dei dati
Per un progetto di marketing il vantaggio principale è avere uno storico interrogabile e controllabile. Questa libertà richiede procedure affidabili, competenze per interpretare i dati e regole di sicurezza adeguate.
Che cosa migliora rispetto a esportazioni manuali e fogli di calcolo
BigQuery permette di interrogare volumi ampi, conservare serie storiche e riutilizzare le trasformazioni. Un team può produrre gli stessi indicatori per decine di proprietà, senza replicare manualmente le formule in tanti file. L'accesso tramite SQL facilita la verifica delle regole di calcolo e la ricostruzione delle analisi, purché l'organizzazione documenti le versioni delle query.
Competenze richieste e problemi che restano aperti
La configurazione di un warehouse richiede competenze di SQL, dati e permessi. I connettori possono cambiare schema o interrompere i trasferimenti; i sistemi di origine mantengono limiti propri. BigQuery non ricostruisce le query anonimizzate di Search Console né gli eventi GA4 che il tracciamento non raccoglie. Un dataset grande e ben organizzato può comunque contenere dati incompleti o interpretazioni sbagliate.
Controlli di qualità, versioni e backup
Una procedura affidabile verifica i giorni disponibili, i volumi acquisiti e la presenza di duplicazioni anomale. Controlla inoltre gli schemi dopo gli aggiornamenti dei connettori, conserva la logica delle trasformazioni e documenta eventuali correzioni. Il livello analitico dovrebbe utilizzare tabelle o viste separate dagli archivi originali; così è possibile ricalcolare un indicatore senza perdere l'esportazione iniziale.
La conservazione nel warehouse non equivale automaticamente a una strategia di backup. Occorre definire come recuperare tabelle cancellate, gestire le scadenze, valutare copie o esportazioni dove necessarie e stabilire chi può modificare o eliminare i dati. La durata dello storico deve riflettere esigenze operative e requisiti legali, non il semplice desiderio di conservare tutto senza limiti.
Privacy, identificativi e controllo degli accessi
Le tabelle GA4 possono contenere identificativi pseudonimi e parametri personalizzati. Un controllo preliminare deve escludere informazioni personali raccolte senza necessità o in violazione delle regole della piattaforma. Le autorizzazioni IAM, la scelta della localizzazione, la minimizzazione e le politiche di conservazione fanno parte della progettazione. La conformità al GDPR dipende dal trattamento complessivo e non deriva automaticamente dalla scelta di un servizio cloud o di una regione europea.
BigQuery, GA4, Search Console e Looker Studio: quali differenze?
Gli strumenti descrivono livelli diversi del lavoro sui dati: raccolta, analisi e visualizzazione. La tabella chiarisce quale servizio produce i dati e quale permette di conservarli o presentarli nei report.
| Strumento | Funzione | Esempio |
|---|---|---|
| GA4 | Raccoglie eventi e produce report sul comportamento | Sessioni, visualizzazioni, eventi chiave |
| Search Console | Descrive il rendimento nella Ricerca Google | Query, clic, impressioni, posizioni |
| BigQuery | Conserva, interroga e trasforma dati | Storici e analisi SQL fra sorgenti |
| Looker Studio | Visualizza informazioni in dashboard | Report periodici e filtri interattivi |
| Google Sheets | Elabora dataset contenuti in fogli | Verifiche e analisi occasionali |
BigQuery non sostituisce i sistemi che raccolgono i dati. Può diventare invece la fonte delle tabelle che una dashboard consulta, con metriche già controllate e definite. Nel collegamento con Looker Studio, la trasformazione SQL può precedere la visualizzazione: l'utente finale consulta indicatori coerenti senza dover conoscere ogni campo degli export originali.
La progettazione di dashboard marketing in Looker Studio può quindi partire da tabelle aggregate e aggiornate in BigQuery. Per un sito con pochi report mensili, invece, Google Sheets o i connettori diretti di Looker Studio possono offrire una soluzione più semplice. Il data warehouse acquista valore quando la complessità reale del problema lo giustifica.
Quando conviene utilizzare BigQuery
La decisione parte dalle domande di analisi, prima ancora che dalla quantità dei dati. Un portale editoriale può volere uno storico SEO pluriennale; un e-commerce può cercare una vista coerente di costi, sessioni e ordini; un'agenzia può avere bisogno di applicare gli stessi controlli a molte proprietà. Per queste esigenze BigQuery offre un ambiente flessibile, purché ci siano risorse per gestirlo.
Per i progetti con più canali la consulenza per una strategia di marketing omnicanale può rendere esplicite le definizioni condivise fra pubblicità, sito e CRM. Confrontare i canali richiede metriche compatibili, una base temporale coerente e la documentazione delle differenze di attribuzione.
| Domanda | Segnale favorevole all'adozione |
|---|---|
| Serve uno storico oltre i report di origine? | Sì, soprattutto per dati SEO granulari e confronti pluriennali |
| Le analisi coinvolgono più sistemi? | Sì, con dimensioni e metriche da riconciliare |
| I report richiedono molte elaborazioni manuali? | Sì, e le stesse trasformazioni ricorrono spesso |
| Esistono competenze SQL e manutenzione? | Sì, interne o attraverso un supporto tecnico dedicato |
| Il budget copre il progetto complessivo? | Sì, inclusi connettori, qualità dei dati e gestione |
In una prima fase può bastare attivare Search Console e GA4, verificare un mese di dati e creare una tabella analitica utile. L'estensione ad altre fonti arriva dopo la validazione. Una soluzione più piccola ma controllabile offre spesso risultati migliori di un warehouse che raccoglie molte informazioni senza definizioni e controlli chiari.
Domande frequenti su Google BigQuery
Alcuni dubbi emergono soprattutto dopo la prima configurazione: tempi delle esportazioni, accesso allo storico, collegamento fra proprietà e affidabilità delle metriche. Le risposte chiariscono i limiti operativi più frequenti.
Quanto tempo impiega Search Console a inviare i primi dati?
Dopo la configurazione corretta, il primo bulk data export può richiedere fino a 48 ore. La presenza del collegamento nelle impostazioni non garantisce da sola che entrambe le tabelle abbiano già ricevuto i dati. Occorre verificare lo stato e ExportLog.
Che cosa succede se l'esportazione giornaliera si interrompe?
Search Console riprova i trasferimenti falliti per circa una settimana. Una lunga interruzione può lasciare giornate senza dati e, dopo errori ripetuti per circa un mese, può interrompere l'intera esportazione. È utile prevedere un controllo regolare del registro e delle comunicazioni della proprietà.
Le conversioni GA4 si possono attribuire alle keyword Search Console?
Un join per URL consente confronti aggregati fra visibilità SEO e comportamento sul sito. Non identifica la keyword che ha prodotto una specifica conversione: le fonti non condividono una chiave di collegamento evento–query e Search Console protegge le ricerche anonimizzate.
Si possono collegare più proprietà allo stesso progetto BigQuery?
Sì. Ogni proprietà GA4 usa il proprio dataset di esportazione; le diverse proprietà Search Console devono scrivere in dataset distinti. Prima di costruire report trasversali occorre verificare permessi, localizzazione e definizioni omogenee delle metriche.
È necessario conoscere SQL per usare BigQuery?
L'interfaccia permette di esplorare dataset e consultare alcune informazioni senza scrivere query. Per trasformazioni personalizzate, controllo delle esportazioni e analisi che combinano sorgenti diverse, SQL rimane la competenza più utile. Un partner tecnico può gestire queste operazioni quando il team marketing consulta soltanto le dashboard finali.
Conclusioni: uno storico utile richiede dati e processi affidabili
BigQuery permette di conservare e interrogare in modo autonomo i dati che GA4, Search Console e altri sistemi rendono disponibili. Per chi si occupa di SEO e digital marketing, il vantaggio più concreto è poter ricostruire serie storiche, verificare variazioni e preparare report che non dipendono da esportazioni manuali.
Le query e il caso applicativo mostrano anche il confine dello strumento: una tabella non corregge gli errori del tracciamento, non recupera automaticamente lo storico perduto e non trasforma clic e sessioni in metriche equivalenti. Un data warehouse efficace nasce da esportazioni controllate, definizioni documentate e analisi che rispondono a domande precise. La scala dell'infrastruttura viene dopo.
Fonti e documentazione ufficiale
Documentazione e riferimenti tariffari verificati il 18 novembre 2026. Prezzi, interfacce e limiti possono cambiare.
Google Cloud – BigQuery pricing. Tariffe per archiviazione, interrogazioni e livello gratuito.
Google Analytics – BigQuery Export. Modalità giornaliera e streaming, tempi, costi e differenze rispetto ai report.
Google Search Console – Tabelle e struttura del bulk data export. Struttura delle tabelle di rendimento ed ExportLog.
